
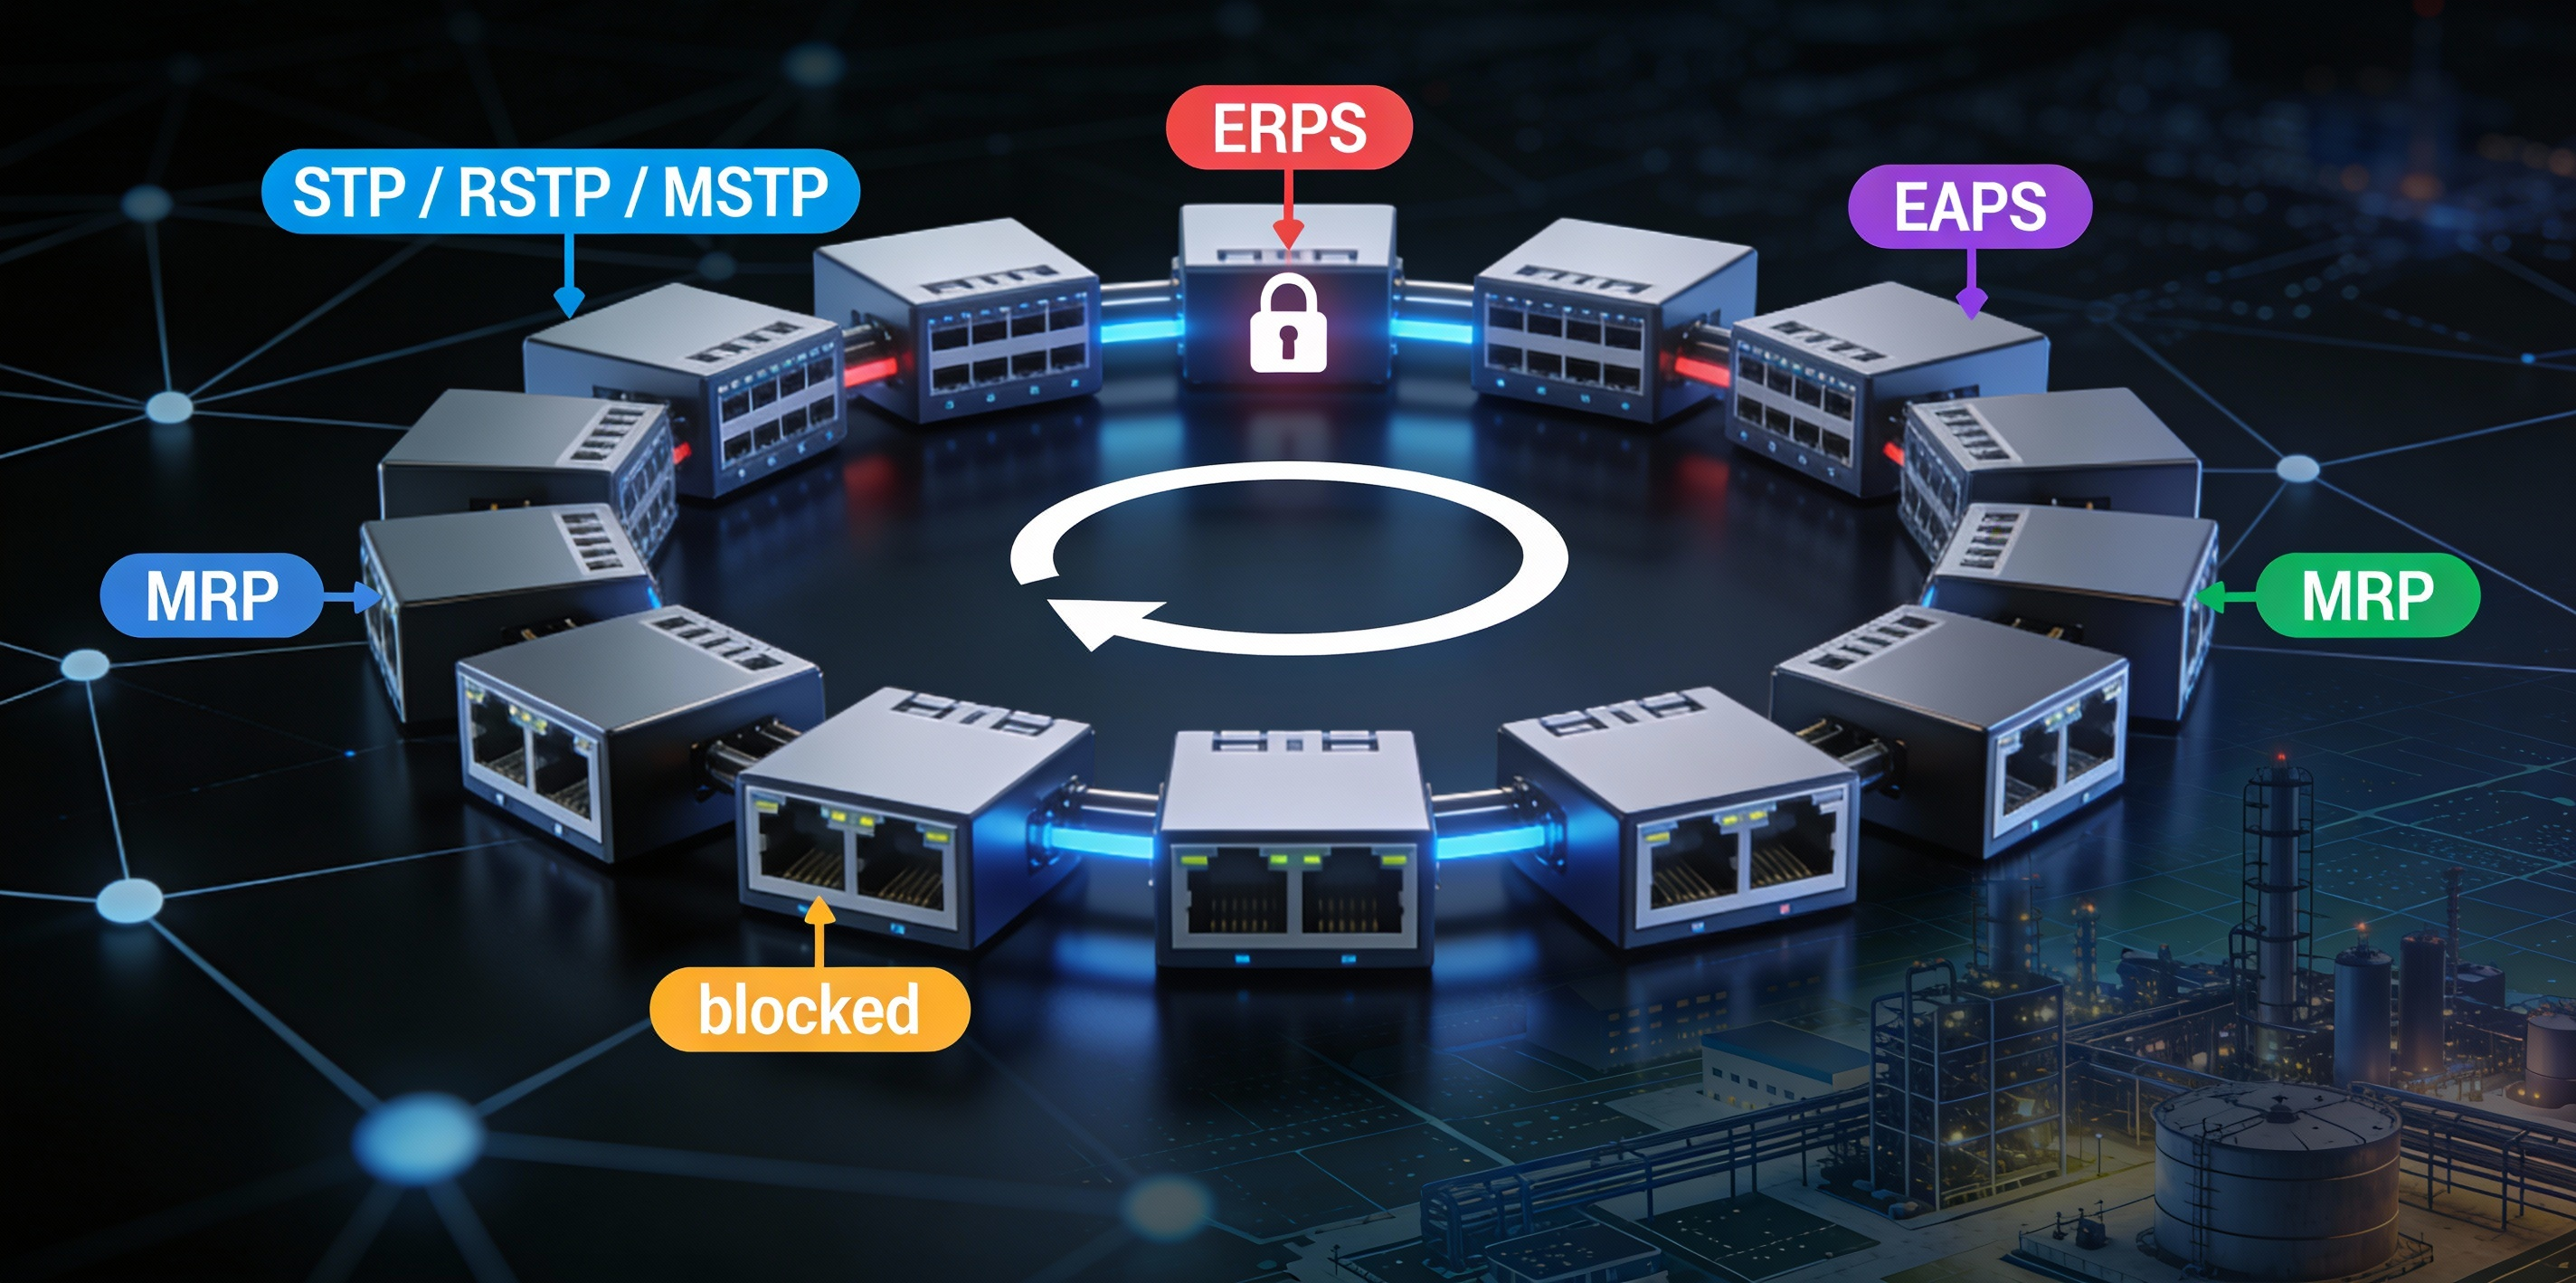
Introducción: ¿Qué es un protocolo de anillo redundante?
Para las redes Ethernet industriales, la fiabilidad operativa es verdaderamente crítica. Una sola falla en la red, como un cable dañado o un dispositivo averiado, puede interrumpir procesos productivos completos y ocasionar pérdidas económicas significativas. Para minimizar este riesgo, los switches industriales emplean tecnología de anillo redundante que garantiza la continuidad operativa mediante el reenvío automático del tráfico alrededor de la falla.
El principio fundamental del protocolo de anillo redundante consiste en bloquear lógicamente un enlace del anillo durante la operación normal, evitando así bucles en la red. Cuando ocurre una falla—ya sea una desconexión de enlace o una avería en un switch—el protocolo desbloquea de manera automática y rápida (normalmente en milisegundos) la ruta en espera, redirigiendo el tráfico y restaurando la comunicación sin intervención manual.
Este mecanismo garantiza que un único punto de fallo no interrumpa los servicios de red, elevando considerablemente la disponibilidad del sistema. Resulta especialmente adecuado para entornos industriales que exigen alta fiabilidad y rendimiento en tiempo real.
En este artículo, analizaremos los protocolos de anillo redundante más comunes para establecer la redundancia en Ethernet industrial.
Artículo relacionado: What Is Network Redundancy? How to Implement Redundancy in Industrial Switches?
Protocolos Comunes de Anillos Redundantes
En infraestructuras Ethernet industriales, existen diversos protocolos de redundancia en anillo. Este artículo se centra en los más comunes y estandarizados:
STP/RSTP/MSTP
ERPS
EAPS
MRP
Cada protocolo presenta distintos mecanismos, tiempos de recuperación y niveles de interoperabilidad. En este artículo no se abordan los protocolos de anillo específicos de proveedores, como Turbo Ring de Moxa y HRP de Hirschmann.
STP / RSTP / MSTP
La familia del Protocolo de Árbol de Expansión (STP) comprende un conjunto de protocolos estándar IEEE, ampliamente empleados en redes Ethernet convencionales y en diversas aplicaciones industriales.
Cómo Funciona STP
BPDU Exchange: Tras el arranque, los conmutadores transmiten periódicamente Unidades de Datos del Protocolo de Puente (BPDUs) para mapear la topología de la red.
Root Bridge Election: Todos los switches comparan los IDs de puente (prioridad + dirección MAC); aquel con el valor más bajo se convierte en el puente raíz.
Path Calculation: Cada conmutador que no es raíz determina la ruta más corta hacia el Puente Raíz basándose en el costo del camino.
Port Role Assignment: Los switches designan un Puerto Raíz (la mejor ruta hacia el Puente Raíz) y Puertos Designados (encargados de gestionar el reenvío del tráfico en cada segmento).
Blocking Redundant Ports: Cualquier puerto que pueda generar un bucle se coloca en estado de bloqueo, impidiendo la transmisión de datos pero continuando con la vigilancia de los BPDUs.
Cuando un enlace o dispositivo falla: los switches detectan el cambio mediante BPDUs, recalculan el árbol de expansión y desbloquean los puertos según sea necesario.

Diagrama 1. Funcionamiento del STP: Selección del Bridge Raíz, Puerto Raíz y Puerto Designado
Lo anterior describe el principio básico de funcionamiento del STP. No obstante, la versión original de STP presenta un tiempo de recuperación relativamente largo, lo que limita su aplicación en entornos sensibles al tiempo. Para superar esta restricción, se desarrollaron dos versiones mejoradas — RSTP (Rapid Spanning Tree Protocol) y MSTP (Multiple Spanning Tree Protocol) — que ofrecen una convergencia más rápida y una mayor flexibilidad en las redes industriales Ethernet modernas.
STP: La versión más elemental previene bucles bloqueando enlaces redundantes y creando una topología lógica libre de ciclos. No obstante, su convergencia es lenta, requiriendo típicamente entre 30 y 50 segundos para la recuperación de la red.
RSTP: Una versión avanzada de STP que logra una convergencia topológica más rápida, por lo general entre 1 y 10 segundos.
MSTP: Basado en RSTP, permite que múltiples VLANs se asignen a una única instancia de spanning tree, facilitando la distribución de carga entre VLANs. MSTP mantiene compatibilidad retrospectiva con STP y RSTP, logrando tiempos de convergencia también inferiores a 10 segundos.
Como estándar internacional, la familia de protocolos Spanning Tree ofrece una interoperabilidad excepcional y soporta diversas topologías físicas. No obstante, en redes industriales de gran escala o complejidad, su rendimiento en la convergencia puede quedar rezagado frente a protocolos industriales anulares especializados, por lo que resulta más idóneo para aplicaciones no críticas en tiempo real o como mecanismo de redundancia de respaldo.
MRP
Media Redundancy Protocol (MRP), definido en la norma IEC 62439-2, es un protocolo estandarizado de redundancia para anillos Ethernet industriales, diseñado para la recuperación ágil de redes.
En un anillo MRP, un dispositivo se configura como Gestor de Redundancia de Medios (MRM), mientras que los demás operan como Clientes de Redundancia de Medios (MRC). El MRM supervisa continuamente el estado del anillo y bloquea normalmente uno de sus puertos para evitar bucles en la red. Ante una falla en un enlace o dispositivo, el MRM desbloquea inmediatamente ese puerto, permitiendo que el tráfico de datos se reoriente a través de la ruta de respaldo.

Diagrama 2. ¿Cómo funciona el Protocolo de Redundancia de Medios MRP?
MRP admite configuraciones flexibles de recuperación, con tiempos típicos de 500 ms, 200 ms, 60 ms, 15 ms e incluso menos de 10 ms en anillos pequeños (hasta 50 conmutadores).
Como estándar industrial internacional, MRP cuenta con el respaldo de numerosos fabricantes de equipos de automatización. Ofrece una recuperación considerablemente más rápida que STP, lo que lo convierte en una opción idónea para la automatización industrial y sistemas de control en tiempo real.
ERPS
Ethernet Ring Protection Switching (ERPS) es un protocolo de redundancia de operador diseñado específicamente para redes de anillo Ethernet, estandarizado bajo la recomendación ITU-T G.8032.
El principio de funcionamiento de ERPS consiste en designar un conmutador como propietario del Enlace de Protección del Anillo (RPL). En condiciones normales de operación, el propietario del RPL bloquea un enlace dentro del anillo para evitar bucles en la red. El protocolo intercambia continuamente mensajes de control (tramas R-APS) entre todos los nodos del anillo para supervisar el estado de los enlaces. Ante una falla en algún enlace, los nodos afectados notifican de inmediato al propietario del RPL, quien desbloquea el enlace previamente bloqueado, permitiendo así redirigir el tráfico a través de la ruta de respaldo.

Diagrama 3. Topología de anillo único ERPS: Enlace normal vs. enlace fallido
La principal ventaja del ERPS radica en su recuperación ultrarrápida, generalmente inferior a 50 ms, lo que lo convierte en la opción idónea para la automatización industrial, la fabricación inteligente y otras aplicaciones críticas donde la alta fiabilidad y el tiempo de inactividad mínimo son imprescindibles.
EAPS
EAPS (Ethernet Automatic Protection Switching) es un protocolo de protección rápida desarrollado inicialmente por Extreme Networks para topologías de anillos Ethernet. Gracias a su eficiencia y diseño robusto, su mecanismo central fue estandarizado como IETF RFC 3619, convirtiéndolo en una tecnología abierta y pública. Aunque sea un estándar, en la práctica, distintos fabricantes pueden presentar ligeras variaciones en la implementación y extensión de RFC 3619.
¿Cómo Funciona EAPS?
El nodo maestro envía periódicamente paquetes de estado para supervisar la integridad del anillo. El puerto secundario permanece bloqueado para evitar la formación de bucles.
Ante una falla en el enlace, el maestro habilita el puerto secundario en modo de reenvío y difunde un mensaje Flush-FDB para redirigir el tráfico por la ruta alternativa.
Cuando se restablece el enlace, el maestro vuelve a bloquear el puerto secundario y envía un mensaje Complete-Flush-FDB para restaurar la ruta de reenvío habitual.
La recuperación suele completarse en un plazo de 50 ms, garantizando una alta disponibilidad de la red.

Diagrama 4. ¿Cómo Funciona EAPS? – Enlaces en Estado Normal
EAPS funciona de manera similar a ERPS, aunque se diferencia en ciertos aspectos. EAPS depende de un nodo maestro único para gestionar tanto el bloqueo como la recuperación, mientras que ERPS emplea un modelo RPL Owner/RPL Neighbor para administrar los enlaces bloqueados. Además, ERPS soporta interconexiones de anillos más complejas y múltiples dominios de anillo, en contraste con EAPS, que está principalmente concebido para topologías de anillo simple o dual.
Comparativa de Rendimiento de Protocolos de Anillo Redundante
Para una visión resumida, la siguiente tabla presenta las características principales.
Protocol | Typical Recovery Time | Device / Network Scale | Key Strengths | Key Weaknesses / Notes |
STP | 30 – 50 seconds | No specific limit | The original, prevents basic loops. | Too slow for modern networks. Legacy protocol, not recommended for new deployments. |
RSTP | 1 – 10 seconds | No specific limit | Much faster convergence than STP. Universal compatibility. Supports any physical topology. | Convergence can be slow in large/complex networks. Not ideal for time-critical rings. |
MSTP | ≤ 10 seconds | No specific limit | Enables load balancing across VLANs. Backward compatible with RSTP/STP. | Configuration is more complex. Convergence speed is still in the second range. |
MRP | < 10 – 500 ms (configurable) | Up to 50 switches | Industrial international standard. Optimized for PROFINET. Deterministic behavior. | Limited to ring topologies. |
ERPS | < 50 ms | Up to 255 nodes per ring | Telecom-grade, fastest international standard. Excellent for multi-vendor environments. | Limited to ring topologies. The top choice for high-speed standard rings. |
EAPS | < 50 ms | Typically single or dual ring | Fast Convergence, Simple mechanism, cost-effective. | Less common than ERPS/MRP, largely superseded. |
Cómo Seleccionar la Opción Más Adecuada para Su Red
Para determinar el protocolo óptimo de anillo redundante, valore sus necesidades en función de estas tres dimensiones fundamentales:
Topología y Escala de Redes
Restricción: ¿Anillo físico limpio?
Sí: Proceda con protocolos optimizados para anillos (MRP, ERPS, propietarios).
No: RSTP/MSTP es la opción principal para gestionar topologías de malla arbitrarias, aceptando una convergencia más lenta (1-10 segundos).
Rendimiento: Objetivo de Tiempo de Recuperación (RTO)
Tolerancia > 1 segundo: RSTP/MSTP resulta adecuado para operaciones no críticas.
Requisito < 100 ms: Exige un protocolo de anillo específico (MRP, ERPS, propietario).
¿Cuáles son sus objetivos en cuanto al entorno técnico y el mantenimiento?
Ejemplo A: Sistemas Industriales Específicos
Si su red se destina principalmente a sistemas industriales de bus como PROFINET, que exigen rigurosos protocolos, MRP suele ser el estándar de facto o mandatorio. Optar por MRP garantiza la mejor compatibilidad y un rendimiento determinista con los dispositivos de campo.
Ejemplo B: Alto Rendimiento, Compatibilidad Multivendedor y Flexibilidad Futura
Si su red funciona como la columna vertebral de la fábrica o centro de datos que integra dispositivos de múltiples proveedores y desea evitar depender exclusivamente de un solo fabricante, ERPS es la opción óptima. Como estándar internacional de grado portador, ERPS ofrece una recuperación inferior a 50 ms, excelente interoperabilidad multivendedor y una escalabilidad duradera para futuras actualizaciones.


