Mostrando entradas con la etiqueta Kyland. Mostrar todas las entradas

martes, 10 de septiembre de 2019

PTC1000 – Conversor PTP a IRIG-B y PPS

PTC1000

El PTC1000 es un conversor que permite la conexión de dispositivos con interfaces de sincronismo IRIG-B o PPS a redes Ethernet con transporte de reloj a través del protocolo IEEE1588v2 PTP. … Read More >PTC1000 – Conversor PTP a IRIG-B y PPS

La entrada PTC1000 – Conversor PTP a IRIG-B y PPS se publicó primero en Blog DAVANTEL.

miércoles, 28 de agosto de 2019

PTC1000 – Conversor PTP a IRIG-B y PPS

PTC1000 200 - PTC1000 - Conversor PTP a IRIG-B y PPS

El PTC1000 es un conversor que permite la conexión de dispositivos con interfaces de sincronismo IRIG-B o PPS a redes Ethernet con transporte de reloj a través del protocolo IEEE1588v2 PTP. … Read More >PTC1000 – Conversor PTP a IRIG-B y PPS

La entrada PTC1000 – Conversor PTP a IRIG-B y PPS se publicó primero en Blog DAVANTEL.

miércoles, 15 de mayo de 2019

jueves, 20 de septiembre de 2018

Webinar - Soluciones para comunicaciones industriales

¿ Quieres conocer de forma rápida nuestras soluciones para comunicaciones industriales?
Apúntate a nuestro webinar y en 45 minutos te explicaremos de forma resumida nuestras soluciones para estos entornos incluyendo routers 3G/4G, switches industriales, conversores de sincronismo y comunicaciones redundantes PRP y HSR.


¿ Quieres conocer de forma rápida nuestras soluciones para comunicaciones industriales?

Apúntate a nuestro webinar y en 30 minutos te explicaremos de forma resumida nuestras soluciones en los siguientes campos:
  • Transmisión por pares de cobre: G.SDHSL.bis

  • Routers 3G y 4G LTE

  • Control de barreras y telecontrol GSM

  • Extensión de servicios legacy sobre SDH/PDH y PTN

  • Soluciones WDM

  • Servidores NTP/PTP con receptor GPS

  • Conversores de sincronismo

  • Conversores de medio y módems serie a fibra

  • Switches industriales

  • Comunicaciones redundantes PRP y HSR

  • SFP compatibles


¿ Te animas ? Sólo tienes que pinchar en el link inferior. ¡ Te esperamos !

Fecha y hora: Viernes, 21 de Septiembre a las 10:00 AM
Duración aprox: 45 min.

lunes, 17 de septiembre de 2018

InnoTrans 2018 - Kyland presenta su gama de switches on-board Aquam EN50155

Kyland presenta su gama de switches on-board Aquam EN50155 en la feria InnoTrans 2018 a celebrarse en Berlín los días 18 a 21 de Septiembre


Nuestro partner Kyland Technology presentará su gama de switches on-board Aquam en la feria InnoTrans a celebrarse en Berlín los días 18 a 21 de Septiembre.

Si tienes pensado visitar la feria no dudes en pasarte por su stand en Hall 4.1 booth 216 donde podrás ver y conocer de primera mano esta familia de switches especialmente diseñados para su instalación y operación dentro de convoys ferroviarios.

La familia Aquam cumple con la normativa IEC61375 para redes de comunicaciones embarcadas incluyendo las funcionalidades TTDP, R-NAT y bypass.

Si no tienes pensado visitar la feria pero quieres ampliar información sobre estos equipos puedes visitar nuestro blog donde detallamos estas y otras funcionalidades.

miércoles, 11 de julio de 2018

Conversión de protocolos IEC61850

La familia de conversores de protocolos DG de Kyland permiten la integración de IEDs con diferentes protocolos en una arquitectura IEC61850 bien como simples bridges o pasarelas o bien como elementos capaces de almacenar datos de los IEDs en memoria interna para luego entregarlos bajo petición al sistema SCADA


La familia de gateways y conversores de protocolo DG-AX de Kyland integran modernas comunicaciones con un diseño robusto de alta fiabilidad y bajo consumo. Esta familia es capaz de realizar la conversión entre diferentes protocolos, la concentración y recopilación de datos en memoria interna y el procesado o cálculos sobre los mismos para su entrega a sistemas SCADA.

La configuración de los equipos se realiza de forma sencilla y gráfica a través de su software ICE capaz de volcar el modelado de objetos y valores en el equipo necesarios y específicos para cada aplicación.

A continuación veremos algunos de los principales escencarios de uso de estos dispositivos

Conversión de protocolos 'Store-and-Deliver'


En esta aplicación el gateway DG actúa por un lado como un master hacia los IEDs definidos y conectados recopilando información de objetos de diferentes protocolos y almacenándola en su memoria interna. Esta información puede ser entregada bajo petición de sistemas superiores tipo SCADA bien bajo el mismo protocolo de comunicaciones o bajo otro cualquiera a través de la conversión y mapeo interno que hayamos definido en nuestra aplicación.

Gateway de comunicaciones IEC61850


En esta aplición, el DG actúa como un proxy inteligente capaz de recopilar datos a través de sus puertos serie y Ethernet. Importando cualquier fichero IEC61850 SCL (.icd/.cid) y mapeando los datos  a los objetos internos recopilados de dichos dispositivos podemos convertir nuestro DG en un IED 61850 virtual de cada a nuestro sistemas SCADA.

Modo de tareas avanzadas


La herramienta gráfica de configuración ICE de la familia DG nos permite también definir tareas u operaciones avanzadas a través de scripts que pueden ser cargados en el dispositivo en modo on-line. A través de estas tareas podemos realizar cálculos lógicos, acumulaciones de resultados, triggers específicos o tareas en batch sobre múltiples IEDs añadiendo un universo de funcionalidades al dispositivo y descargando algunas tareas en nuestro SCADA.


Si quieres ampliar esta información puedes visitar nuestra página de gateways inteligentes o descargarte el documento Kyland-TechnicalPaper-ProtocolConversion

lunes, 2 de julio de 2018

DG-A6 - Servidores de terminales de 8/16 puertos con redundancia Ethernet

El DG-A6 es un servidor de terminales con 8 o 16 puertos RS232/485/422 y 2 puertos Gigabit y 4 puertos Fast Ethernet. Podemos segmentar los puertos serie asociándolos a diferentes puertos Ethernet o incluso asociarlos a varios puertos a la vez para dotarlos de redundancia active/standby o load-balancing.


El servidor de terminales DG-A6 proporciona hasta 16 puertos RS232/485/422 en un formato para montaje en sub bastidores de 19'' y altura 1U. Dispone de 2 puertos Gigabit 10/100/1000BaseTX y 4 puertos 10/100BaseTX. Cada puerto puede mapearse a uno o varios puertos serie y también un puerto serie puede asignarse a más de un puerto Ethernet para redundancia. Esta redundancia admite dos modos de funcionamiento: active/standby donde un puerto está activo y el otro en espera o load-balancing donde el equipo reparte el tráfico entre ambos puertos Ethernet. En el modo active/standby asignamos ambos interfaces físicos a un mismo interfaz ethernet vitual con una única dirección IP y MAC de cara al servidor de terminales y por tanto al envío o recepción de tráfico serie.

Asimismo, el equipo soporta fuente de alimentación redundante.

lunes, 14 de mayo de 2018

PTC1000 - Conversor PTP a IRIG-B y PPS

El PTC1000 es un conversor que permite la conexión de dispositivos con interfaces de sincronismo IRIG-B o PPS a redes Ethernet con transporte de reloj a través del protocolo IEEE1588v2 PTP.

El PTC1000 es un conversor PTP a IRIG-B y PPS que permite la conexión de dispositivos con este tipo de interfaces de sincronismo a redes Ethernet con transporte de reloj a través de protocolo IEEE 1588v2.d

Prestaciones


  • Soporta IEEE 1588v2 con una precisión que alcanza ±100ns.

  • Soporta ITU-T.G.8261/G.8262 SyncE con una precisión que alcanza ±50ns con SyncE habilitado.

  • Dispone de 1 puerto 100Base-FX SC/ST/FC o 1 puerto 10/100Base-TX RJ45 como entrada IEEE1588.

  • Soporta una salidas PPS, IRIG-B TTL e IRIG-B con modulación AM.

  • Soporta los formatos IRIG-B000, B001, B002, B003, B004, B005, B006, B007, B120, B121, B122, B123, B124, B125, B126, B127.

  • Cumple con las normativas IEC 61850-3 e IEEE1613.

  • Certificados CE y UL508.
Si quieres ampliar información o descargarte el datasheet puedes visitar nuestra página web de conversores PTP a IRIG-B y PPS.


lunes, 30 de abril de 2018

Opal5GS - Switch industrial Gigabit no gestionable con 4 puertos PoE/PoE+

Switch industrial full gigabit no gestionable con 4 puertos PoE/PoE+ (15,4W/30W) y un puerto GE/GX.

El Opal5GS es un switch industrial no gestionable que proporciona 1 puertos GX o GE y 4 puertos 10/100BaseTX con soporte PoE/PoE+ (802.3af/at) hasta 30W por puerto (total 120W). Está especialmente diseñado para su operación en ambientes agresivos soportando temperaturas de operación entre -40°C y 85°C , protección IP40 y EMC nivel 4.

Visita nuestra página de switches industriales PoE para ver otros modelos o descargarte el datasheet del equipo.

lunes, 23 de abril de 2018

Webinar Gratuito - Switches industriales y soluciones DRP, PRP y HSR de Kyland

Te presentamos la gama de switches, conversores de medio y servidores de terminales industriales de Kyland así como sus soluciones para conexión en anillo DRP y redes redudantes PRP y HSR


Hoy te presentamos dos nuevos webinars gratuitos

Presentación de la gama de productos Kyland


En este webinar presentaremos de forma rápida la gama de productos de Kyland incluyendo los switches modulares, switches para 19'' y carril DIN', conversores de medio y módems serie. También presentaremos los servidores de terminales, gateways Modbus  y la nueva gama de switches 'entry level' Opal.
Fecha y hora: Miércoles, 25 de Abril a las 16:00

Duración aprox: 30 min.


Soluciones redundantes DRP, PRP y HSR


En este webinar presentaremos los protocolos de comunicación en anillo DT-ring, DT-ring+ y DRP de Kyland así como los módulos y equipos para comunicaciones redundantes bajo protocolos PRP (Paralell Redundancy Protocol) y HSR (High Availability Seamless Redundancy Protocol).
Fecha y hora: Miércoles, 25 de Abril a las 16:45

Duración aprox: 30 min.


lunes, 16 de abril de 2018

Opal - Switches industriales económicos no gestionados de altas prestaciones

Switches industriales ‘entry-level’ de bajo coste. Ultra bajo consumo. Garantía de 5 años. Protección IP40, rangos de temperatura de -10ºC a +60ºC y -40ºC a +75ºC.

Modelos de 5 y 8 puertos con uplinks de fibra


La familia de switches Opal  dispone de modelos de 5 y 8 puertos: Opal5 y  Opal8. Los modelos Opal5 pueden incorporar un  uplink de fibra mientras que los modelos Opal8 pueden  incorporar uno o dos uplinks de fibra. El resto de puertos son de cobre  10/100BaseTX.

Sencillos pero ajustados a sus necesidades


Uplinks de  fibra multimodo y monomodo. Conectores SC o ST. Alcances de 40, 60 y 80Km sobre  fibra óptica monomodo y 5Km sobre fibra óptica multimodo.


Bajo precio,  altas prestaciones


  • Doble entrada de alimentación con protección de  polaridad.

  • Alimentación de rango extendido: 9-60  VDC

  • Soporte IEEE 802.3i, 802.3u, 802.3x

  • Capacidad de la  tabla MAC: 2K

  • Packet Buffer:  1Mbit

  • Packet  Forwarding Rate: 0.8Mpps

  • Switching  Delay: <5μs

Dos rangos de temperatura


La familia Opal soporta temperaturas  de funcionamiento de entre -40ºC y +75ºC. Sin embargo para aquellas  instalaciones no tan exigentes existen modelos más económicos '-E' que soportan  temperaturas entre -10ºC y +60ºC.

Bajo consumo, 5 años de garantía y MTBF superior a 40  años


Con un consumo inferior en el peor de los casos a  1.7W en el Opal5 y 2.64W en  el Opal8, estos modelos disponen de 5 años de  garantía y un MTBF de 361.000 horas, superior a 40 años.


Más información, datasheets y compra Opal online en nuestra web.

miércoles, 11 de abril de 2018

IEC61735 - Redes Ethernet a bordo de trenes - Los Miércoles de Tecnología

El estándar IEC61735 define las redes de comunicaciones a bordo de trenes. En este artículo nos centraremos en la interconexión entre vagones y en las redes dentro de cada vagón así como las funcionalidades específicas requeridas para este tipo de instalaciones.


La tecnología Ethernet ha sido ampliamente utilizada en las redes de comunicación en el sector ferroviario (TCN) y también para la conexión a bordo de cualquier elemento terminal para control, videovigilancia o servicios de información al pasajero

El organismo internacional de estandarización IEC ha estructurado estas redes de un modo jerárquico en ETB (Ethernet Train Backbone) a través del estándar IEC61375-2-5 y ECN (Ethernet Consist Network) a través del estándar IEC61375-3-4. ETB se encarga de la interconexión e interoperabilidad de las comunicaciones entre vagones mientras que ECN se encarga de la comunicación de los dispositivos terminales dentro de cada vagón.

Estos estándares han tenido que surgir atendiendo a las especiales características del entorno a bordo donde, a diferencia de las redes tradicionales donde la configuración es estática, en los convoys se intercambian y se cambian de posición vagones de forma continua atendiendo a diferentes razones operativas.

En este sentido las redes han de saber adaptarse a todas estas reconfiguraciones y por eso el estándar incluye las funcionalidades TTDP, R-NAT y otras que a continuación veremos.

TTDP, Train Topology Discovery Protocol


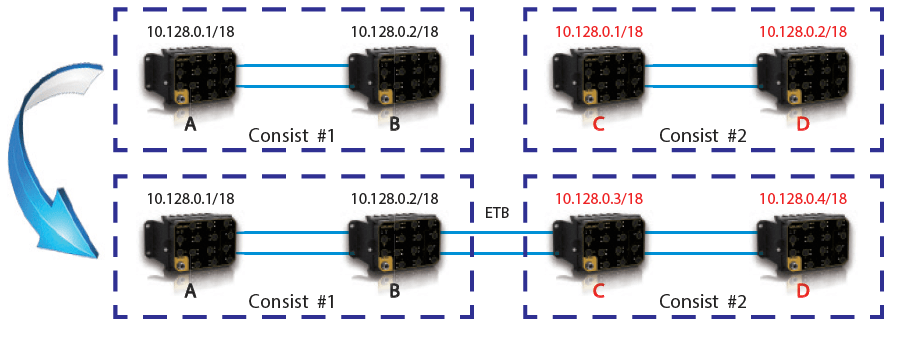
Este protocolo permite la reconfiguración IP automática de todos los switches de un vagón a fin de evitar duplicidades.

TTDP, Train Topology Discovery Protocol

En el ejemplo anterior vemos como los nodos del vagón #2 reconfiguran su direccionamiento IP para no coincidir con los del vagón #1.

R-NAT, Railway-Network Address Translation


De cara a poder mantener la misma configuración en todos los dispositivos terminales en cada vagón y al mismo tiempo permitir la comunicación de los mismos entre diferentes vagones, el protocolo R-NAT realiza una traslación de direcciones IP permitiendo duplicados en los equipos conectados a los switches.

R-NAT, Railway-Network Address Translation

Bypass


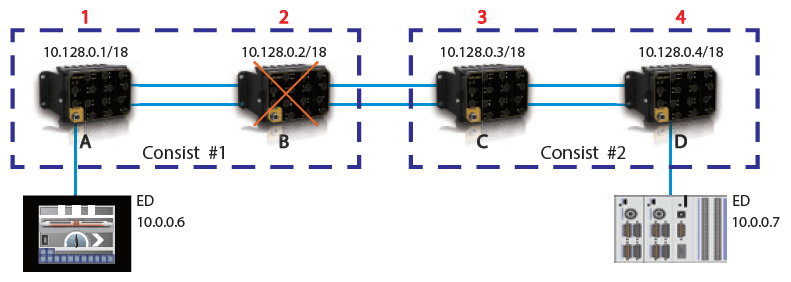
Dado que la comunicación entre vagones es fundamental, es necesario dotar a los elementos de la red de una función de bypass que permita mantener la comunicación cuando alguno de los elementos quede inoperativo. En el siguiente ejemplo vemos que la función bypass en el nodo ETBN_B asegura la comunicación entre terminales conectados al resto de nodos. Únicamente se ven afectados aquellos terminales conectados al nodo inoperativo.

bypassSoluciones Kyland compatibles IEC61735


Nuestro partner Kyland Technology poseedor de la certificación IRIS para entornos ferroviarios dispone de una familia de switches embarcados según el estándar EN50155 y EN50121-4. Dentro de esta gama, los modelos gestionables de nivel 2 y nivel 3 incorporan las funcionalidades descritas en esta publicación así como otras prestaciones como alimentación de amplio rango entre 24Vdc y 110Vdc con salidas PoE/PoE+.  Puedes ampliar la información en nuestra página web de switches embarcados EN50155.Aquam8612-8112Aquam8512A

lunes, 19 de marzo de 2018

Nueva gama de switches embarcados IEC61375 (TTDP, R-NAT y bypass)

Gama Aquam 81XX (L2) y 86XX (L3) de switches embarcados EN510155 con soporte de las últimas funcionalidades específicas para el sector ferroviario según el estándar IEC61375


Nuestro partner Kyland Technology dispone de una amplia gama de switches industriales para ser insalados a bordo de trenes y otros convoyes.

Hoy te queremos presentar la gama Aquam86XX de nivel 3 o Aquam81XX de nivel 2 en sus versiones de 8+4G, 16+4G y 24+4G puertos

Aquam8612-8112

Aquam = Robusto


Protección IP65 con carcasa de aluminido a prueba de humedad y polvo.
Conectores M12 que aseguran la firmeza y sujección ante vibraciones.
Sistema pionero de disipación de calor para evitar sobrecalentamientos aún con la máxima potencia entregada a través de los puertos PoE/PoE+.

EN50155 / EN50121 /EN45545

Alta densidad de puertos


Hasta 24+4G puertos con conectores M12. Puerto de consola, contactos de alarma y alimentación también con conectores M12.


Máxima potencia PoE+ de 240W


Posibilidad PoE y PoE+ en todos los puertos 100M.120W disponibles a través de la fuente de alimentación interna del equipo con rango de entrada 24-120Vdc (booster). Y también 120W adicionales si conectamos una fuente exterior adicional al switch.


Gigabit hardware bypass


En una topología lineal como la que tenemos en un tren el fallo de uno de los dispositivos intermedios puede bloquear la comunicación entre sí de los equipos a ambos lados del dispositivo averiado.
Para evitarlo, los switches Aquam disponen de un mecanismo de bypass mecánico que da continuidad a la señal Gigabit Ethernet en caso de fallo de un equipo. De esta forma, sólo los terminales conectados a este equipo se verán afectados.


TTDT:Train Topology Discovery Protocol


Debido al hecho de que la topología de la red en el tren puede variar en el acoplamiento y desacoplamiento de diferentes vagones. la norma IEC61375 define el protoloc TTDT (Train Topololoy Discovery Protocol) que permite la reconfiguración automática de los equipos de cara a simular siempre la misma topología.


R-NAT:Railway-Network Adress Translation


IEC61735 también define esta funcionalidad de cara a mantener una misma configuración en los dispositivos terminales conectados al switch en cada vagón. Con R-NAT los switches realizan una traslación de direcciones entre las IPs duplicadas de los terminales y las IPs únicas de los switches en los diferentes vagones.

R-NAT, Railway-Network Address Translation

Redundancia llevada al extremo


En un entorno tan crítico como el ferroviario, la gama Aquam soporta topo tipo de redundancias incluyendo:
• VRRP (Virtual Router Redundancy Protocol)
• RSTP (Rapid Spanning Tree Protocol)
• DRP (Distributed Redundancy Protocol IEC62439-6) con recuperación < 20ms
• MRP (Media Redundancy Protocol IEC62439-2)
• Link Agreggation (LACP, IEEEE802.3ad)


Puedes ampliar información en la página web de Kyland.

lunes, 26 de febrero de 2018

Gateways Modbus TCP a Modbus RTU/ASCII de 1,2 o 4 puertos

La familia de gateways KGW3000 permite la conversión entre protocolo Modbus TCP y Modbus RTU/ASCII. Existen modelos de 1, 2 o 4 puertos serie todos ellos en formato para montaje en carril DIN.


Nuestro partner Kyland Technology anuncia el lanzamiento de la familia KWG3000 de gateways Modbus de 1, 2 o 4 puertos serie en formato para inserción en carril DIN.
Los gateways KGW3101, KGW3102 y KGW3204 permiten convertir entre protocolos Modbus TCP y Modbus RTU/ASCII. Cada puerto Ethernet puede ser accesible por 16 dispositivos TCP master/client o 16 dispositivos TCP slave/server. A su vez, cada puerto serie puede gestionar hasta 128 nodos master/slave.


 Los equipos soportan modo Transparente y modo Agente. En modo Transparente, el gateway hace bypass y traduce los comandos Modbus TCP/RTU/ASCII. En modo Agente, el gateway hace un polling a los dispositivos Modbus slave y almacena los datos recogidos en su memoria interna. El Modbus master puede recuperar estos datos de los slaves directamente de la memoria del gateway.

Puedes ampliar la información de éste y otros modelos de gateways inteligentes en  nuestra página web.

lunes, 19 de febrero de 2018

SICOM3000A - Switch industrial para montaje en carril DIN

El SICOM3000A viene a reemplazar a su predecesor SICOM3000A ofreciendo importantes mejoras: SFP 100/1000BaseX, redundancia MSTP y DHP, soporte RADIUS, un menor consumo y también un mejor precio.

Kyland anuncia el lanzamiento del modelo SICOM3000A como evolución de la familia SICOM3000.


Con una configuración de puertos idéntica a su predecesor, permite hasta 8 puertos de cobre 10/100BaseTX (de los cuales dos pueden ser también de fibra óptica integrados 100/100BaseFX) y 2 uplinks de fibra SFP 1000Base-X, este switch soporta múltiples protocolos en anillo: DT-Ring (recuperación <50ms), DRP (recuperación <20ms), STP/RSTP/MSTP así como VLAN, multicast, QoS, SSH y muchas otras funcionalidades de nivel 2. El equipo puede gestionarse por CLI, Telnet y Web y también se integra en la plataforma Kyvision basada en SNMPv1/v2c/v3.


El SICOM3000A está especialmente diseñado para su funcionamiento en entornos agresivos soportando un rango de temperatura en operación de entre -40ºC y +85ºC, EMC nivel 3 y protección IP30.


Puedes descargarte el datasheet en nuestra página web de switches industriales para carril DIN.

lunes, 12 de febrero de 2018

Ruby3A - RedBox PRP/HSR

Ruby3A es una RedBox que permite la conexión de dispositivos o switches con un único puerto Ethernet a redes de comunicaciones industriales redundantes PRP y HSR.


Ruby3A es una RedBox que permite la conexión de dispositivos y switches con un único puerto Ethernet a redes redundantes PRP y HSR.

Existen varias configuraciones: desde el modelo con 3 puertos combo donde un puerto permite la conexión de un único dispositivo o switch SAN (Single Attach Network) y los otros dos puertos conectan a redes paralelas PRP o en anillo HSR hasta un módulo más completo con 8 puertos para la conexión de dispositivos SAN y dos puertos PRP/HSR.


Puedes ampliar información y descargarte el datasheet del equipo en nuestra página web sobre comunicaciones industriales redundantes.

Si estás interesado en saber cómo funcionan las redes industriales redundantes también puedes ver los post sobre redes  PRP y HSR en nuestro blog.

miércoles, 17 de enero de 2018

DRP (Distributed Redundancy Protocol) - Los Miércoles de Tecnología

El protocolo DRP IEC62439-6 permite la conexión en anillo con tiempos de recuperación inferiores a 50ms independientemente del número de nodos y necesita una mínima configuración.


Si en los pasados dos post de Tecnología vimos los protocolos PRP y HSR de redundancia que se caracterizan ambos por duplicar los paquetes y evitar así la pérdida de los mismos, hoy veremos el protocolo DRP para conexión de switches industriales en anillo

¿ Qué es DRP y cómo funciona ?


DRP (Distributed Redundandy Protocol) es un protocolo para conexión en anillo que fue diseñado por nuestro partner Kyland y estandarizado bajo la norma IEC62439-6.

A diferencia de otros protocolos, DRP no define de forma estática un nodo como master sino que este rol se negocia entre los diferentes nodos del anillo y varía en función de los cambios en la topología del anillo. De esta forma se simplifica la configuración de los nodos donde únicamente debemos indicar los puertos que pertenecen a cada uno de los anillos DRP.

Veamos este mecanismo a través de un ejemplo. En la figura inferior vemos un anillo sin ningún enlace caído. El nodo A se configura como Root del anillo de forma automática y por tanto bloquea el puerto 2 para evitar el bucle de tráfico.

A continuación se produce un corte entre los nodos C y D. Automáticamente estos nodos C y D lo detectan en sus puertos 6 y 7 respectivamente y se reconfiguran como Roote Root y B-Root bloqueando estos puertos mientras que el nodo A pasa a modo normal desbloqueando el puerto 2.

Por último, cuando se restablece el enlace, el nodo D permanece con el rol de Root que había tomado a partir de la caída del enlace mientras que el nodo C pasa a modo normal desbloqueando el puerto 6.

Dual Homing Protocol


Es otro mecanismo de redundancia que consiste en conectar dos puertos de un mismo nodo a dos nodos diferentes de un mismo anillo como vemos en la figura siguiente.


Únicamente uno de los puertos (primary) cursa el tráfico mientras que el otro (backup) permanece en reserva (standby). En el caso de que uno de los dos switches conectados en el Ring A tenga un problema, la conexión entre ambos anillo se mantendrá a partir del otro enlace.

No se trata de un sistema totalmente redundante ya que en caso de que el nodo del Ring B que sirve ambos enlaces quede inoperativo se perderá la conexión entre ambos anillos.

DRP inter-ring backup


Es una extensión del protocolo DRP que permite la conexión redundante de anillos DRP sin la limitación del DHP que hace recaer esta redundancia en un único nodo (single point of failure).


Como puede apreciarse en la figura anterior, los anillos A y B se interconectan entre sí a través de los nodos S4, S5 y S6. Únicamente uno de ellos, S5 está activo mientras que los otros dos bloquean sus puertos de interconexión. En el caso de que S5 quede inoperativo o caiga el enlace con S8, o bien S4 o bien S6 desbloquearán su puerto. La configuración de DRP inter-ring sólo necesita realizarse en los nodos S4,S5 y S6 pero no en los nodos S7,S8 y S9.

miércoles, 10 de enero de 2018

HSR (High-availability Seamless Redundancy) - Los Miércoles de Tecnología

HSR permite la conexión redúndate de equipos Ethernet en anillo. Cada nodo duplica el paquete enviándolo en ambos sentidos de forma que nunca se pierda ninguno de ellos aún en caso de caída de algún enlace o nodo.


En el pasado post hablamos del protocolo PRP donde cada nodo se conecta a través de sus dos puertos a dos redes Ethernet totalmente independientes.

¿ Qué es HSR y cómo funciona ?


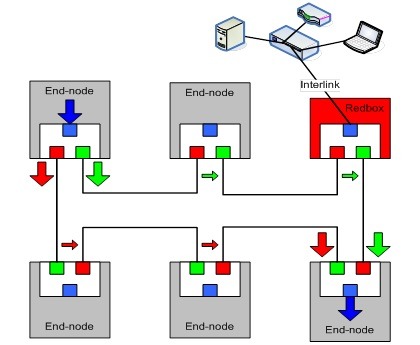
Hoy hablaremos de HSR (High-availability Seamless Redundancy) donde al igual que en PRP cada nodo debe disponer de dos puertos Ethernet y envía el paquete duplicado por ambos puertos. Pero a diferencia de PRP, los nodos HSR forman un anillo a través de sus dos puertos tal y como se muestra en la siguiente figura.


Básicamente cada nodo en modo tránsito hace un forward del paquete que recibe por un puerto hacia el otro puerto y así en ambos sentidos. El nodo mantiene una tabla de los paquetes recibidos de forma que si recibe por un puerto un paquete que envió por el otro, no hace el forward entre puertos como puede verse en el gráfico anterior. De esta forma cada nodo, y no únicamente uno de ellos habilitado como maestro, evita el bucle de tráfico en el anillo.

Tanto PRP como HSR están normalizados por el estándar en IEC 62439-3:2016. Como en el caso de PRP, HSR es un protocolo ZPL (Zero Packet Loss) ya que al duplicarse todos los paquetes, en caso de pérdida de conexión entre dos nodos, el nodo destino recibirá siempre un paquete por uno de ambos sentidos no perdiendo información.

Al igual que en PRP, si queremos conectar a una red HSR un nodo con un único interfaz Ethernet tendremos que usar una RedBox que permita distribuir el paquete recibido del nodo a través de ambos puertos del anillo y en recepción seleccionar el primer paquete recibido y descartar el segundo paquete duplicado antes de entregarlo de vuelta al nodo.

Además de la RedBox también podemos usar una QuadBox que como su nombre indica dispone de 4 interfaces HSR lo que permite conectar dos anillos HSR entre sí.

¿ Cómo funciona internamente un nodo HSR ?


De forma similar a como vimos en PRP, cada nodo incorpora a nivel de LRE la lógica necesaria para:
  • en transmisión, duplicar el paquete con el header HSR correspondiente a través de dos dos puertos

  • en tránsito, enviar por un puerto los paquetes recibidos por el otro y que no sean para nosotros

  • en recepción, seleccionar el primer paquete y descartar el duplicado


En el caso de una RedBox el funcionamiento es muy parecido, actuando el LRE como proxy entre la red HSR y el puerto Ethernet que conecta al switch del que cuelgan los nodos con un único interfaz de red. Este proxy lleva el control de todas las tramas entre los diferentes nodos y la red HSR agregando los encabezados HSR en función de la dirección MAC origen del tráfico.


¿ Cómo descartar los duplicados de las trama ?


De nuevo, al igual que en PRP, los nodos HSR añaden un encabezado a las tramas Ethernet.

Este encabezado incluye un identificador del anillo (HSR-ET) y del sentido (path) así como un número de secuencia que se va autoincrementando con cada paquete y que permite detectar duplicados y posibles reordenaciones de tramas. El parámetro size también nos permite identificar, de forma rápida y sencilla, una trama HSR de otro no HSR en función del tamaño de la trama.

Soluciones HSR de Kyland


Por último queremos recordarte que nuestro partner Kyland dispone de una RedBox en formato para carril DIN así como un módulo PRP/HSR para insertar en la familia GPT de switches modulares de 19''.

miércoles, 20 de diciembre de 2017

PRP (Parallel Redundancy Protocol) - Los Miércoles de Tecnología

En el post de hoy hablaremos del protocolo PRP de redundancia para redes Ethernet de tipo industrial y en el siguiente post hablaremos del protocolo HSR también para redundancia pero en esta ocasión en anillo.
¿Qué es PRP y cómo funciona?
En pocas palabras,...

En el post de hoy hablaremos del protocolo PRP de redundancia para redes Ethernet de tipo industrial y en el siguiente post hablaremos del protocolo HSR también para redundancia pero en esta ocasión en anillo.

¿Qué es PRP y cómo funciona?


En pocas palabras, PRP se basa en que cada equipo conectado a la red PRP transmite la información por dos redes en paralelo totalmente independientes. Para ello el nodo necesita dos interfaces de red, una conectada a cada una de las redes. En recepción, el nodo destino del paquete recibirá el mismo por ambas interfaces, tomando el primer paquete que le llegue y descartando el segundo (duplicado)

PRP es un protocolo con dos claras ventajas y un claro inconveniente. Las ventajas son:
  • no necesitamos ninguna redundancia o protección en cada una de las redes, es decir, no necesitamos topologías en anillo o similares ya que la redundancia en sí se consigue por el hecho de duplicar las redes. Esto significa que podemos usar switches u otros dispositivos económicos (incluso no gestionables si no hemos de usar vlans)

  • es un protocolo de los llamados ZPL (Zero Packet Loss), es decir, en caso de caída de una de las redes, no perdemos ni un solo paquete ya que éstos siempre van duplicados. Ningún protocolo en anillo por rápido que sea su tiempo de recuperación es ZPL ya que siempre se perderá algún paquete entre el tiempo de caída del anillo y la conmutación de caminos para su recuperación

Por el contrario, el inconveniente es también claro: necesitamos duplicar la infraestructura de red ya que tendremos siempre dos redes independientes en paralelo. Eso sí, como ya hemos dicho, estas redes no necesitan protecciones adicionales.

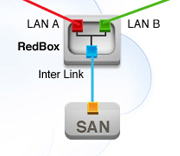
En el diagrama siguiente vemos un esquema de una típica red PRP en la que conectamos dos tipos de dispositivos: SAN o Single Attach Networks, son aquellos nodos que sólo tienen un interfaz de red y que por tanto no pueden conectarse directamente a una red PRP en paralelo y los DANP o Dual Attach Network in Parallel que sí tienen dos interfaces de red con funcionamiento PRP y por tanto pueden conectarse directamente a ambas redes (A y B).
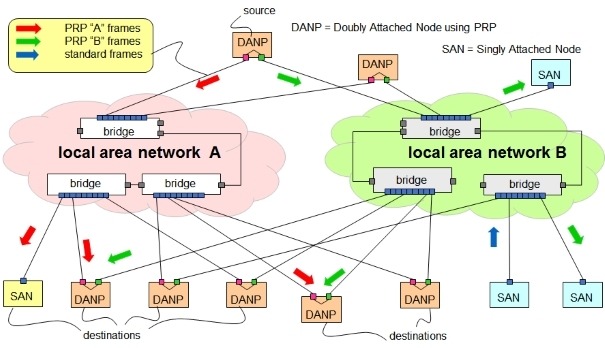


En el primer caso de los SAN, necesitamos un dispositivo intermedio normalmente llamado RedBox que nos permita duplicar el tráfico recibido del SAN hacia dos puertos en paralelo hacia la red PRP.
¿Cómo funciona internamente un dispositivo PRP?


Si hacemos un zoom a un dispositivo con capacidades PRP podemos ver que es algo bastante más complicado que un nodo de red con con interfaces de red.
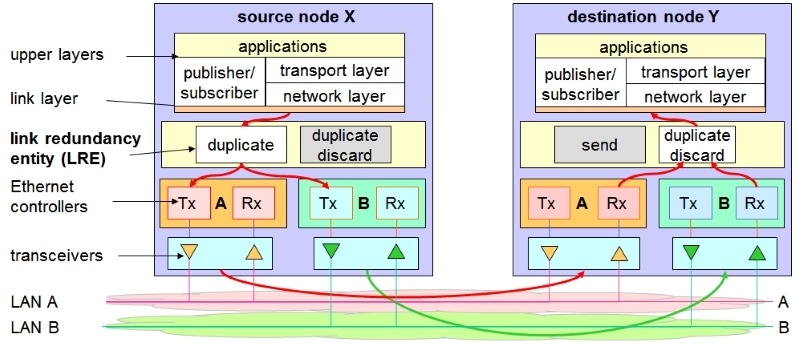


Como podemos ver la implementación del protocolo PRP residen entre los controladores Ethernet y el llamado Link Redundancy Entity. Básicamente estos niveles deben encargarse en la transmisión de un paquete de duplicarlo entre ambos interfaces físicos y en la recepción de dicho paquete en recibir el primero de ellos y descartar el duplicado.

La idea de hacer recaer todo este proceso en los niveles inferiores del stack de protocolos es poder liberar al procesador del nodo de estas tareas y al mismo tiempo independizar el tratamiento de los paquetes Ethernet del hecho de que la red sea o no PRP.

¿Cómo descartar los duplicados de las tramas?


Para llevar a cabo las funciones anteriormente descritas, PRP añade una serie de campos específicos al formato de trama Ethernet estándar.
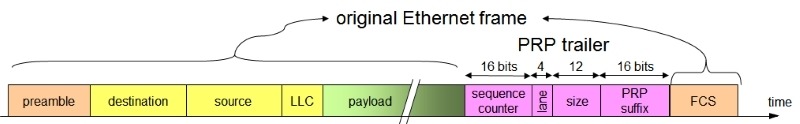


Como vemos este PRP tráiler está formado por:
  • un número de secuencia de 16 bits

  • un identificador de LAN de 4 bits (1010 (0x0A) para la LAN_A y 1011 (0x0B) para la LAN-B)

  • un indicador de longitud de 12 bits (cuenta la longitud del payload de la trama excluyendo los bytes de tags de vlans y el PRP tráiler)

  • un sufijo PRP (opcional) en caso de tramas cortas donde necesitemos un relleno

En transmisión el nodo PRP incrementa el número de secuencia con cada paquete (este número de secuencia es individual para cada dirección MAC destino) y añade el identificador de LAN a cada una de las redes. Por último añade el identificador de longitud de trama PRP.

En recepción el número de secuencia nos permite detectar duplicados o cambios de orden de paquetes e identificar perfectamente los mismos. Asimismo, el identificador de longitud nos permite distinguir de forma rápida las tramas PRP de las que no son PRP y que puedan llegar por el mismo interfaz de red.

Cuando se empieza a recibir un paquete por una de las redes se abre una ventana de tiempo de disponibilidad en la otra red durante la cual estamos recibiendo y procesando el paquete. Tan pronto detectemos que el paquete es correcto se cierra dicha ventana de disponibilidad y descartamos el paquete que pudiéramos estar recibiendo por la segunda red. Si por el contrario el primer paquete es erróneo, lo descartaremos y pasaremos a tomar el segundo paquete.

Supervisión en redes PRP


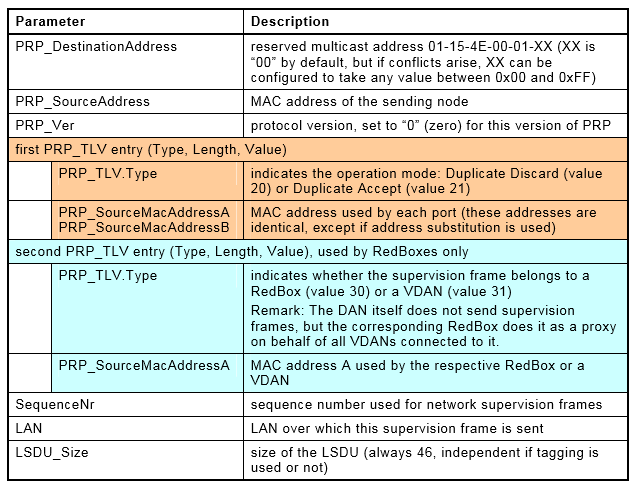
Para su correcto funcionamiento, una red PRP necesita que todos sus nodos tengan un cierto control y supervisión de la situación de dicha red. Por ejemplo: necesitan unas tablas comunes con los números de secuencia de los paquetes que les permitan detectar duplicados o cambios de secuencia o incluso nodos que han desaparecido de la red y dejan de enviar y recibir paquetes.

De cara a llevar todo este control, los nodos de las redes PRP y especialente las RedBox que deben llevar el control de dispositivos no PRP conectados a ellas se intercambian unos paquetes de supervisión que pueden ser tagged o untag en función de la configuración de la red de transporte que los une y en la que podemos encontrar los campos descritos en la siguiente tabla.

Soluciones PRP de Kyland


El fabricante Kyland dispone de dos productos con capacidades PRP
  • Ruby3A - es una Redbox en formato para carril DIN con dos uplinks GX y uno o varios puertos de acceso para nodos SAN

  • Módulo PRP/HSR para la gama de switches modulares GPT. Este módulo permite integrar al switch y a todos los SAN conectados a él e una red PRP o HSR dotándoles de redundancia